TL;DR: Schneller API-Vergleich
OpenAI Whisper API - Insgesamt am genauesten, ideal für Batch-Verarbeitung, 0,006 $/Minute
AssemblyAI - Am besten für Echtzeitanwendungen, 300 ms Latenz, 0,15 $/Stunde Streaming
Deepgram Nova-2 - Schnelles Streaming, 50+ Sprachen, individuelle Preise
Amazon Transcribe - Solide AWS-Integration, 0,024 $/Minute, 100+ Sprachen
Microsoft Azure Speech - Enterprise-Funktionen, moderate Genauigkeit, 0,024 $/Minute
Google Cloud Sprache zu Text - 125+ Sprachen, aber die geringste Genauigkeit in Benchmarks
Rev AI - Genauigkeit auf menschlichem Niveau, 0,022 $/Minute, am besten für anspruchsvolle Transkriptionen
IBM Watson Speech - Fokus auf Unternehmen, maßgeschneiderte Modelle, 0,024 $/Minute
Speechmatics Ursa - Fortschrittliche Sprachunterstützung, spezialisierte Dialekte, 0,30+ $/Stunde
Picovoice Leopard - Verarbeitung direkt auf dem Gerät, datenschutzfreundlich, einmalige Lizenzgebühr
Beste Sprache zu Text API: Die kurze Antwort
Die beste Sprache zu Text API hängt davon ab, was du baust. Für hochpräzise Batch-Transkriptionen solltest du mit OpenAI Whisper starten. Für Live-Untertitel, Sprachassistenten oder Streaming-Funktionen in deinem Produkt solltest du AssemblyAI und Deepgram in die engere Auswahl nehmen. Wenn dein eigentliches Problem darin besteht, in bestehenden Apps schneller zu schreiben, nutze lieber ein fertiges Tool wie Voicys Spracherkennungs-App, anstatt eine API-Integration zu entwickeln.
Brauchst du eine Sprache zu Text API oder ein Tool für Voice-Workflows?
Kurze Antwort: Nutze eine Sprache zu Text API, wenn du Sprachfunktionen in dein eigenes Produkt integrieren willst. Nutze ein Workflow-Tool wie Voicy, wenn dein Team Texte in Apps diktieren möchte, die es bereits nutzt – ganz ohne den Aufbau oder die Wartung einer eigenen Spracherkennungs-Infrastruktur.
Dieser Unterschied ist wichtig, da viele Teams nach einer API suchen, obwohl sie eigentlich nur eine schnellere Spracheingabe für Support-Antworten, Vertriebsnotizen, Produktspezifikationen, Meeting-Nachbereitungen oder browserbasiertes Schreiben benötigen. Eine API gibt Entwicklern die volle Kontrolle. Ein fertiges Workflow-Tool bringt nicht-technischen Teams sofortige Geschwindigkeit.
Anwendungsfall | Beste Lösung | Warum |
|---|---|---|
Transkription in deine eigene App integrieren | Sprache zu Text API | Du kontrollierst die Benutzeroberfläche, die Audio-Pipeline, die Speicherung und das Nutzererlebnis. |
Hochgeladene Audiodateien transkribieren | API oder fertige App | Nutze eine API für Produktfunktionen; nutze Voicy, wenn du einfach nur präzise Dateitranskriptionen ohne Entwicklungsaufwand brauchst. |
In Gmail, Docs, Notion, ChatGPT oder Browser-Formulare diktieren | Workflow-Tool für Spracheingabe | Ein fertiges Tool ist schneller, da kein Integrationsaufwand anfällt. |
Echtzeit-Untertitel oder Sprachbefehle bauen | Sprache zu Text API | Du benötigst Streaming, Latenzkontrolle und ein individuelles Produktverhalten. |
Wenn du eine API für Sprache-zu-Text vergleichst, weil dein Team zu viel tippt, wirf auch einen Blick auf Spracherkennungssoftware, Audio-zu-Text-Konvertierung und Sprache zu Text in ChatGPT. Diese Seiten zeigen dir den Weg ohne Programmieren.
Die beste No-Code-Alternative zu einer Spracherkennungs-API
Nutze eine API, wenn du eine Spracherkennung innerhalb deines eigenen Produkts brauchst. Nutze Voicy, wenn die Aufgabe einfacher ist: Diktiere in Gmail, Google Docs, Notion, ChatGPT, Browser-Formulare, Desktop-Apps oder hochgeladene Audio-Workflows, ohne dafür Entwicklungszeit einzuplanen.
Frage | Bessere Lösung |
|---|---|
Bauen wir Sprachfunktionen für unsere Kunden? | Spracherkennungs-API |
Müssen Teamkollegen einfach nur schneller schreiben können? | |
Brauchen wir sowohl App-Transkription als auch tägliches Diktieren? | API für das Produkt, Voicy für den Team-Workflow |
Warum Entwickler Spracherkennungs-APIs vergleichen
Spracherkennung ist heute fester Bestandteil von Support-Tools, Meeting-Produkten, Sprachassistenten, Telefonanalysen, Barrierefreiheitsfunktionen und Medien-Workflows. Die Wahl der API beeinflusst Genauigkeit, Latenz, Kosten, Datenschutz und wie viel Entwicklungsarbeit dein Team später leisten muss.
Das Risiko dabei: Die Seiten der Anbieter sind oft auf unterschiedliche Stärken optimiert. Eine API kann hervorragend für hochgeladene Dateien sein, aber unpraktisch für das Streaming. Eine andere ist vielleicht schnell genug für Live-Sprachassistenten, wird bei hoher Skalierung jedoch teuer. Bevor du dich für einen Anbieter entscheidest, kläre, ob du Batch-Transkription, Echtzeit-Streaming, Sprechererkennung (Diarization), mehrsprachige Unterstützung, ein eigenes Vokabular oder ein lokales Deployment brauchst.
So wählst du eine Sprache zu Text API aus
Vergleiche APIs immer mit den echten Audiodateien, die in deinem Produkt anfallen. Eine saubere Demodatei reicht nicht aus. Teste verrauschte Telefonate, Akzente, lange Aufnahmen, Fachbegriffe, durcheinandersprechende Personen und die Latenz, die deine Nutzer tolerieren.
Genauigkeit: Hält das Transkript auch bei echten Nutzeraufnahmen stand?
Latenz: Ist es schnell genug für ein Live-Nutzererlebnis oder nur für hochgeladene Dateien?
Entwicklererlebnis: Sind die SDKs, Webhooks, Streaming-Dokumentationen und die Fehlerbehandlung verständlich?
Gesamtkosten: Beachte Mindestgebühren, Speicherplatz, erneute Versuche, eigene Modelle und Support-Stufen.
Datenschutz: Prüfe Datenspeicherung, regionale Kontrollen, Trainingsrichtlinien und Bereitstellungsoptionen.
Die besten Spracherkennungs-APIs für Entwickler
1. OpenAI Whisper API
Die Whisper-API von OpenAI gilt konsistent als das genaueste Modell zur Spracherkennung. Es glänzt besonders beim Umgang mit Hintergrundgeräuschen, Akzenten und Fachvokabular.
Wichtigste Features:Unterstützt über 99 Sprachen
Hervorragende Rauschunterdrückung
Erstklassige Formatierung und Zeichensetzung
Zeitstempel auf Wortebene
Preise: 0,006 $ pro Audiominute
Ideal für: Batch-Verarbeitung, Content-Erstellung, hohe Genauigkeitsansprüche
Einschränkungen: Keine native Echtzeit-Streaming-API (erfordert eigene Implementierung)
2. AssemblyAI Universal-Streaming
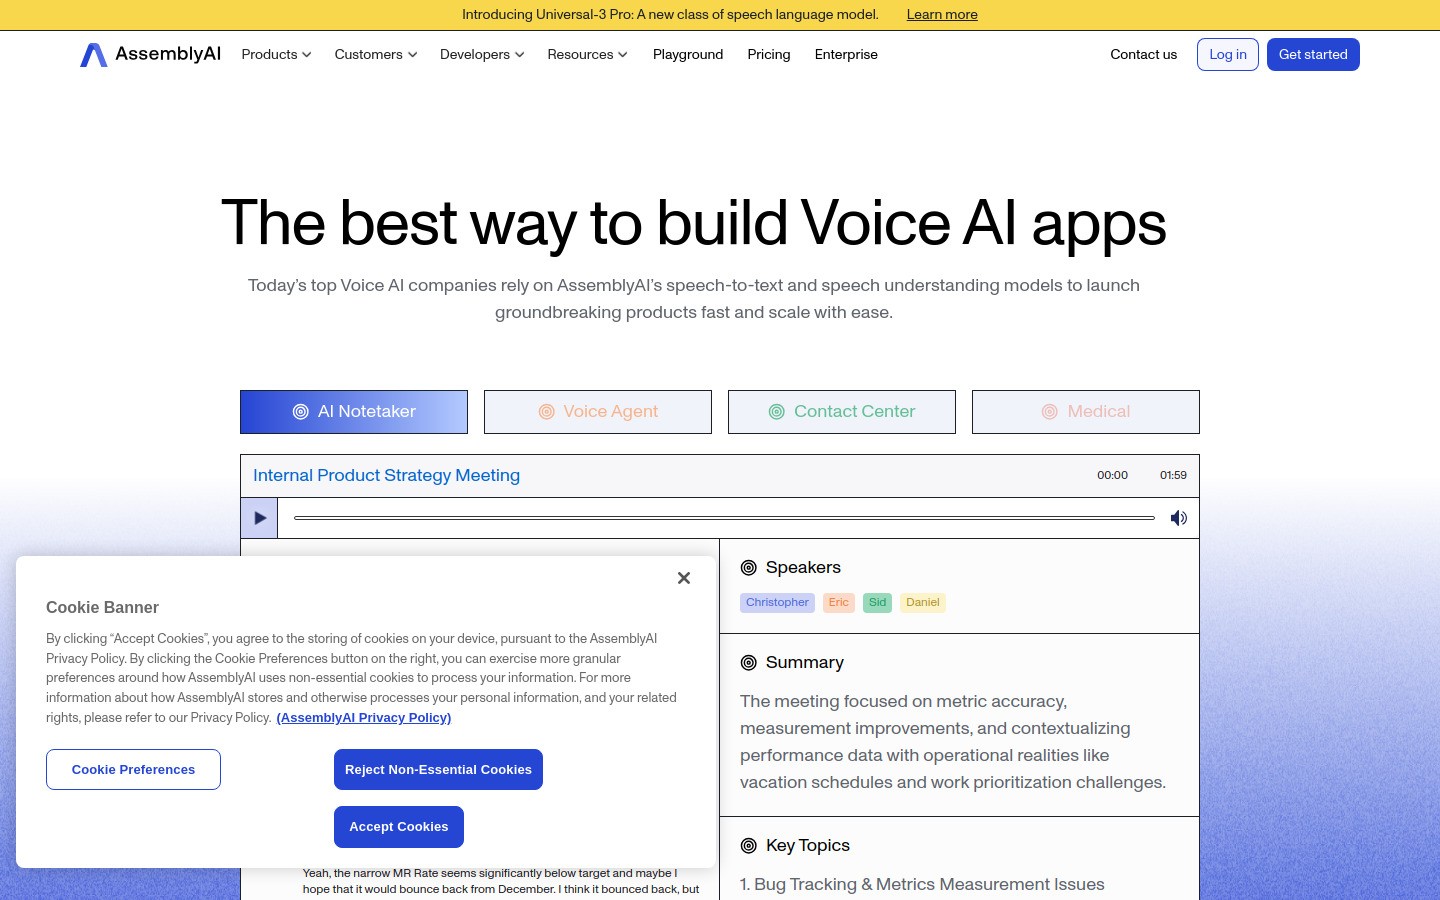
AssemblyAI bietet die beste Echtzeit-Spracherkennung mit einer Latenz von 300 ms und einer garantierten Verfügbarkeit von 99,95 %.
 Wichtigste Features:
Echtzeit-Verarbeitung unter 500 ms
Unveränderliche Transkripte (Wörter ändern sich nachträglich nicht mehr)
Sprechererkennung (Diarization)
Unterstützung für eigenes Vokabular
Preise: 0,15 $/Stunde für Streaming, 0,12 $/Stunde für Batch
Ideal für: Sprachassistenten, Live-Untertitelung, Conversational AI
Einschränkungen: Hauptsächlich auf Englisch fokussiert (mehrsprachiges Modell separat erhältlich)
Wenn dein Team eher eine tägliche Spracheingabe statt einer tief integrierten Entwickler-API sucht, teste Voicy und halte deinen Entwicklern den Rücken für das eigentliche Produkt frei.
3. Deepgram Nova-2
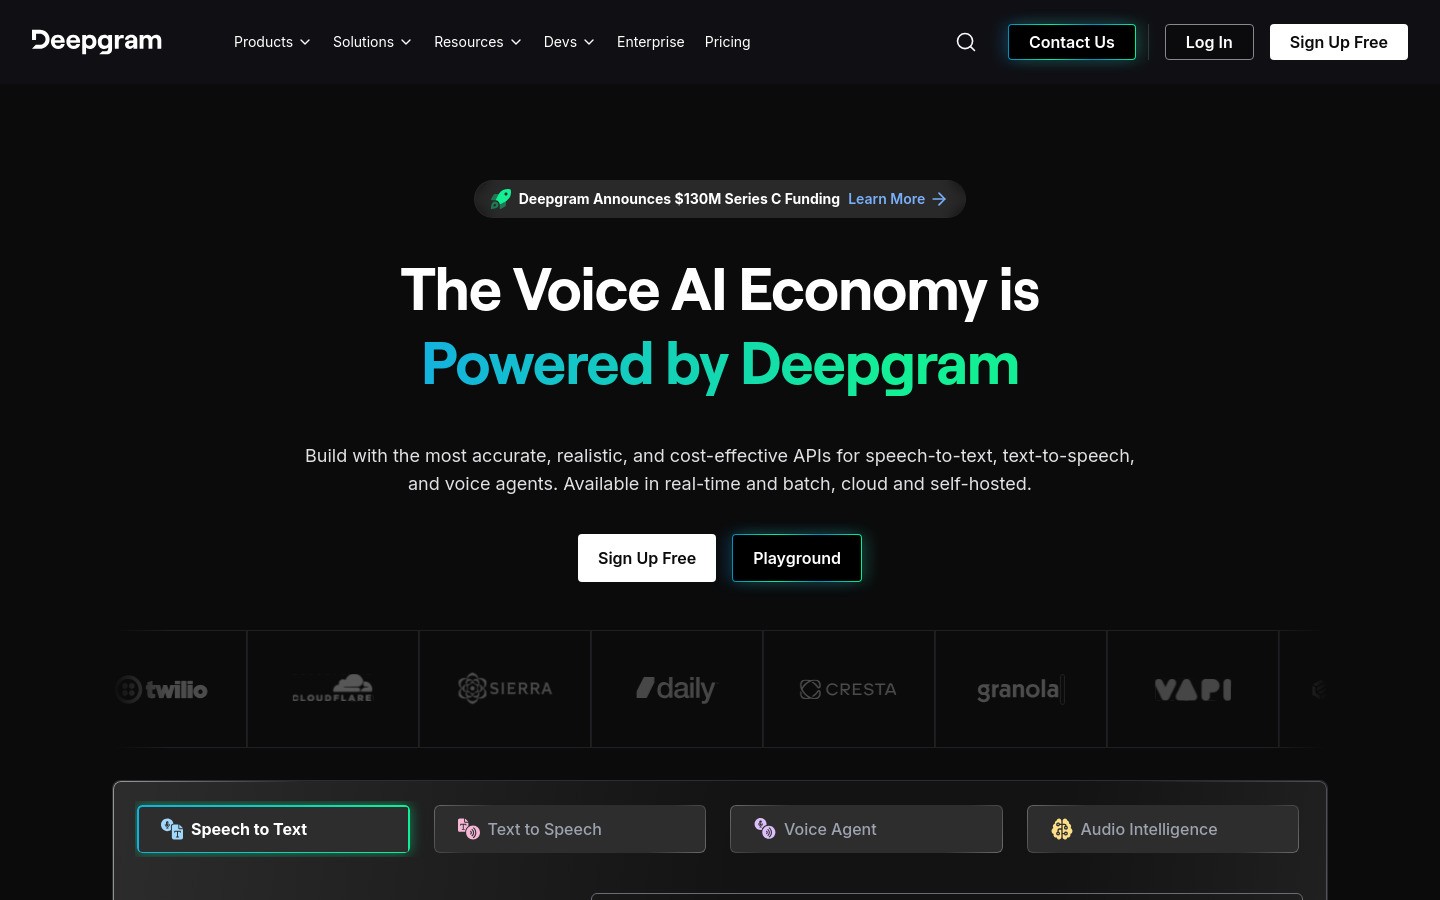
Das Nova-2-Modell von Deepgram bietet schnelle Streaming-Funktionen mit starker mehrsprachiger Unterstützung.
 Wichtigste Features:
Über 50 Sprachen in Echtzeit
Eigenes Vokabular und Domänenanpassung
Streaming mit geringer Latenz (unter 500 ms)
Fortschrittliche Audio-Intelligenz-Funktionen
Preise: Individuelle Preise basierend auf dem Nutzungsvolumen
Ideal für: Mehrsprachige Anwendungen, maßgeschneiderte Integrationen
Einschränkungen: Preisanfrage über den Vertrieb erforderlich, komplexe Einrichtung
4. Amazon Transcribe
AWS Transcribe liefert solide Leistung innerhalb des Amazon-Ökosystems. Es bewältigt Echtzeit-Streaming gut und unterstützt über 100 Sprachen.
 Wichtigste Features:
Über 100 unterstützte Sprachen
Starke AWS-Integration
Eigene Vokabular- und Sprachmodelle
Spezialisierungen für Medizin und Call Center
Preise: 0,024 $ pro Minute (Pay-As-You-Go)
Ideal für: AWS-basierte Anwendungen, Compliance im Unternehmen
Einschränkungen: Komplexe Einrichtung, erfordert S3-Integration für Batch-Verarbeitung
5. Microsoft Azure Speech Services
Microsoft Azure Speech bietet solide Leistung mit starken Enterprise-Funktionen und Compliance-Optionen.
 Wichtigste Features:
Über 90 Sprachen und Dialekte
Eigene Modelle und Ausspracheanpassung
Enterprise-Sicherheit und Compliance
Integration in Microsoft 365
Preise: 0,024 $ pro Minute in der Standard-Stufe
Ideal für: Microsoft-Ökosystem, Enterprise-Umgebungen
Einschränkungen: Moderate Genauigkeit im Vergleich zu den Spitzenreitern
6. Google Cloud Sprache zu Text
Google Cloud Sprache zu Text bietet eine breite Sprachunterstützung, schneidet in unabhängigen Benchmarks zur Genauigkeit jedoch oft am schwächsten ab.
 Wichtigste Features:
Über 125 unterstützte Sprachen
Automatische Zeichensetzung und Formatierung
Sprechererkennung
Training eigener Modelle
Preise: 0,024 $ pro Minute (die ersten 60 Minuten pro Monat sind kostenlos)
Ideal für: Google Cloud-Integrationen, Legacy-Anwendungen
Einschränkungen: Belegt in Genauigkeitstests regelmäßig die hinteren Plätze, besonders bei unruhigem Audio
7. Rev AI
Rev AI kombiniert automatisierte Spracherkennung mit optionaler menschlicher Überprüfung für maximale Genauigkeit. Perfekt für geschäftskritische Inhalte.
 Wichtigste Features:
Genauigkeit auf menschlichem Niveau verfügbar
Automatische Sprecheridentifikation
Themen- und Stimmungsanalyse
Professionelle Formatierung
Preise: 0,022 $ pro Minute für KI, 1,50 $ pro Minute für menschliche Überprüfung
Ideal für: Juristische Transkriptionen, Krankenakten, kritische Inhalte
Einschränkungen: Höhere Kosten für die menschliche Prüfung, längere Bearbeitungszeit
8. IBM Watson Sprache zu Text
IBM Watson Speech konzentriert sich auf Enterprise-Deployments mit starken Anpassungsoptionen.
Wichtigste Features:Maßgeschneiderte Akustik- und Sprachmodelle
Branchenspezifisches Vokabular
On-Premises-Bereitstellungsoptionen
Sicherheitsfunktionen für Konzerne
Preise: 0,024 $ pro Minute, individuelle Tarife für Unternehmen verfügbar
Ideal für: Große Unternehmen, Anforderungen an maßgeschneiderte Modelle
Einschränkungen: Komplexe Einrichtung, erfordert technisches Expertenwissen
9. Speechmatics Ursa
Speechmatics Ursa ist darauf spezialisiert, unterschiedlichste Akzente und Dialekte mit modernster Sprachverarbeitung zu meistern.
 Wichtigste Features:
Über 50 Sprachen mit Dialektunterstützung
Außergewöhnlich gute Akzenterkennung
Echtzeit- und Batch-Verarbeitung
Fortschrittliche Interpunktion und Formatierung
Preise: Ab 0,30 $ pro Stunde, Mengenrabatte verfügbar
Ideal für: Mehrsprachige Anwendungen, diverse Sprechergruppen
Einschränkungen: Höhere Preisklasse, eingeschränkte kostenlose Nutzung
10. Picovoice Leopard
Picovoice Leopard läuft vollständig auf dem Endgerät und ist damit die perfekte Lösung für datenschutzrelevante Anwendungen.
 Wichtigste Features:
Vollständige Offline-Verarbeitung
Es verlassen keine Daten das Gerät
Plattformübergreifende Unterstützung
Geringe Ressourcenanforderungen
Preise: Einmalige Lizenzgebühr ab 0,90 $ pro Gerät
Ideal für: Datenschutzsensible Apps, Offline-Anforderungen
Einschränkungen: Geringere Genauigkeit als Cloud-Lösungen, beansprucht Geräteressourcen
API-Vergleichstabelle
API | Bester Anwendungsfall | Sprachen | Echtzeit | Preise | Genauigkeit |
|---|---|---|---|---|---|
OpenAI Whisper | Batch-Verarbeitung | 99+ | Nur individuell | 0,006 $/Min. | Hervorragend |
AssemblyAI | Echtzeit-Apps | Englisch und weitere | 300 ms | 0,15 $/Std. | Hervorragend |
Deepgram | Mehrsprachiges Streaming | 50+ | <500 ms | Individuell | Stark |
AWS Transcribe | AWS-Ökosystem | 100+ | 1–3 s | 0,024 $/Min. | Stark |
Azure Speech | Microsoft-Stack | 90+ | 1–3 s | 0,024 $/Min. | Gut |
Google Cloud | Google-Ökosystem | 125+ | 1–3 s | 0,024 $/Min. | Ausreichend |
Rev AI | Kritische Inhalte | Englisch | Nein | 0,022 $/Min. | Hervorragend |
IBM Watson | Enterprise Custom | 20+ | Ja | 0,024 $/Min. | Gut |
Speechmatics | Akzent-Erkennung | 50+ | Ja | 0,30+ $/Std. | Stark |
Picovoice | Datenschutz/Offline | Englisch | Ja | 0,90 $/Gerät | Gut |
Wann du welche Sprache zu Text API nutzen solltest
Für Sprachassistenten und Chatbots
Wähle AssemblyAI oder Deepgram. Sprachassistenten benötigen Antwortzeiten von unter 500 ms, um natürlich zu wirken. Diese APIs liefern die Geschwindigkeit, die deine Nutzer erwarten.
Für Content-Erstellung und Transkription
Entscheide dich für OpenAI Whisper oder Rev AI. Wenn Genauigkeit wichtiger ist als pure Geschwindigkeit, bieten diese Lösungen die beste Worterkennung und Formatierung.
Für Enterprise-Anwendungen
Zieh AWS Transcribe, Azure Speech oder IBM Watson in Betracht. Diese Plattformen bieten Compliance-Features, maßgeschneiderte Modelle und Enterprise-Support.
Für datenschutzsensible Apps
Nutze Picovoice Leopard. Da es komplett lokal auf dem Gerät läuft, verlassen keine Sprachdaten das System des Nutzers.
Echtzeit- vs. Batch-Verarbeitung
Sprache zu Text APIs arbeiten auf zwei verschiedene Arten:
Echtzeit-Streaming: Verarbeitet die Sprache direkt bei der Entstehung über WebSockets. Perfekt für Live-Anwendungen wie Sprachassistenten oder Videoanrufe. Stell dich auf Latenzen von 300 ms bis 3 Sekunden ein.
Batch-Verarbeitung: Du lädst fertige Audiodateien zur Transkription hoch. Das ist genauer, dauert aber etwas länger. Ideal für aufgezeichnete Inhalte, Podcasts oder Interviews.
Die meisten Entwickler, die interaktive Apps bauen, brauchen Echtzeit-Streaming. Für reine Content-Workflows reicht die Batch-Verarbeitung meist völlig aus.
Genauigkeits-Benchmarks: Was du vor dem Start prüfen solltest
Öffentliche Benchmarks und die Dokumente der Anbieter sind hilfreich, ersetzen aber nicht deinen eigenen Testlauf. Die Genauigkeit hängt stark von Akzenten, Mikrofonqualität, Hintergrundgeräuschen, Fachvokabular, der Sprache selbst und der Frage ab, ob das System Textteile in Echtzeit streamen muss.
Die engere Wahl für die meisten Teams: OpenAI Whisper, AssemblyAI, Deepgram und Speechmatics sind gute Startpunkte, weil sie die wichtigsten Abwägungen abdecken: Genauigkeit, Streaming, Sprachunterstützung und das Entwicklererlebnis.
Die passende Cloud-Plattform: AWS, Azure und Google Cloud sind oft dann die beste Wahl, wenn deine Anwendung bereits in dem jeweiligen Ökosystem läuft – besonders, wenn es um Einkaufsprozesse, Logging oder Compliance-Prüfungen geht.
Lokale oder Offline-Lösungen: Picovoice und selbst gehostete Whisper-Setups sind wichtig, wenn du lokale Datenverarbeitung brauchst. Allerdings verlagern sie auch mehr Verantwortung auf dein Entwicklerteam.
Preise und versteckte Kosten im Überblick
Die Preise für Spracherkennung können je nach Nutzungsmuster stark variieren:
Preise pro Minute: Die meisten APIs verlangen etwa 0,022 bis 0,024 $ pro Minute. OpenAI Whisper ist mit 0,006 $/Minute am günstigsten.
Aufschläge für Streaming: Echtzeit-APIs sind teurer. AssemblyAI verlangt zum Beispiel 0,15 $/Stunde für Streaming im Vergleich zu 0,12 $/Stunde bei der Batch-Verarbeitung.
Versteckte Kosten, die du bedenken solltest:Speicherkosten für die Audiodateien (AWS, Google, Azure)
Gebühren für den Datentransfer bei großen Datenmengen
Kosten für das Training eigener Modelle
Support-Gebühren für Enterprise-Kunden
Berechne deine Gesamtkosten basierend auf deinem erwarteten Audiovolumen und nicht nur nach den reinen Minutenpreisen.
Komplexität der Integration: Was dich erwartet
Einfache Integration: AssemblyAI, Deepgram und Rev AI bieten einfache REST-APIs. Audio hochladen, Transkript abholen.
Mittlere Komplexität: OpenAI Whisper erfordert für die Echtzeitnutzung das Aufteilen der Audios in Segmente („Chunking“). Dank guter Dokumentation ist das aber gut machbar.
Hohe Komplexität: AWS, Google Cloud und Azure erfordern oft mehrere Schritte – Datei in den Cloud-Speicher hochladen, Transkriptions-Job starten, Ergebnisse von separaten Endpunkten abrufen.
Plane die Integrationszeit fest in deinen Projektplan ein. Einfache APIs lassen sich in wenigen Stunden integrieren, komplexe können Tage oder Wochen dauern.
Sprachunterstützung im Realitäts-Check
Marketing-Versprechungen wie „über 100 Sprachen“ sagen oft wenig über die tatsächliche Qualität aus. Hier ist der aktuelle Stand:
Hervorragende Unterstützung: Englisch, Spanisch, Französisch, Deutsch, Mandarin
Gute Unterstützung: Italienisch, Portugiesisch, Japanisch, Koreanisch, Arabisch
Eingeschränkte Unterstützung: Die meisten anderen Sprachen, besonders bei der Nutzung in Echtzeit
Teste deine Ziel-Sprachen ausgiebig, bevor du dich festlegst. Bei weniger verbreiteten Sprachen kann die Genauigkeit schnell um 20 bis 30 % abfallen.
Die No-Code-Alternative: Voicy
Eine eigene Spracherkennung in deine App zu integrieren, kostet Zeit. Wenn du die Funktionen ohne Entwicklungsaufwand nutzen willst, ist Voicy die passende Lösung.
Voicy bietet eine direkt einsatzbereite Spracherkennung für beliebte Plattformen:
Perfekt für Teams, die heute noch mit der Spracheingabe starten wollen, ohne selbst etwas zu programmieren. Teste Voicy 7 Tage lang kostenlos.
Tipps für die technische Umsetzung
Echtzeit-Umsetzung
Für eine reibungslose Echtzeit-Spracherkennung:
Nutze WebSocket-Verbindungen statt ständigem HTTP-Polling
Implementiere eine zuverlässige Erkennung von Sprechpausen (Endpointing)
Puffere Audio in Blöcken von 250 ms für beste Performance
Sorge für eine stabile automatische Wiederverbindung bei Netzwerkabbrüchen
Optimierung der Genauigkeit
So verbesserst du die Qualität der Transkripte:
Nutze ein eigenes Vokabular für branchenspezifische Fachbegriffe
Sende sauberes Audio (16 kHz, Mono, WAV-Format)
Aktiviere automatische Zeichensetzung und Formatierungs-Features
Nutze die Sprechererkennung bei Aufnahmen mit mehreren Personen
Kosten optimieren
So senkst du deine API-Kosten:
Komprimiere Audio vor dem Senden (ohne die Qualität zu stark zu beeinträchtigen)
Nutze eine Erkennung von Stille, um leere Passagen zu überspringen
Verarbeite mehrere Dateien im Batch, um bessere Tarife zu erreichen
Nutze Caching für wiederkehrende Audioinhalte
Sicherheits- und Datenschutz-Überlegungen
Sprachdaten sind sensibel. Achte auf folgende Punkte:
Datenspeicherung: Die meisten Cloud-APIs speichern Audio nur temporär. Prüfe die Richtlinien deines Anbieters genau.
Compliance: Stelle sicher, dass der Anbieter die nötigen Zertifizierungen (wie DSGVO) vorweisen kann.
On-Device-Optionen: Picovoice und selbst gehostete Whisper-Modelle halten alle Daten lokal auf dem Gerät.
Verschlüsselung: Alle großen APIs nutzen HTTPS. Überprüfe bei sensiblen Daten jedoch, ob eine Ende-zu-Ende-Verschlüsselung möglich ist.
Zukunftstrends in der Spracherkennung
Der Markt für Spracherkennung entwickelt sich rasant weiter:
Multimodale KI-Integration: Modelle wie Google Gemini verarbeiten Sprache direkt zusammen mit Text und Bildern. Erwarte 2026 noch mehr LLM-basierte Spracherkennung.
Edge-Deployment: Schnellere Mobilprozessoren ermöglichen eine hochwertige Erkennung direkt auf dem Gerät. Die Vorteile bei Datenschutz und Latenz treiben diesen Trend voran.
Gefühle und Stimmung: Moderne APIs erkennen mittlerweile nicht mehr nur Wörter, sondern auch die Stimmung und die Absicht des Sprechers.
Echtzeit-Übersetzung: Die direkte Übersetzung von Sprache zu Sprache wird für globale Anwendungen immer alltäglicher.
Entwickler, die eine Spracheingabe für KI-Coding-Assistenten suchen, können Voicy auch für die Claude Code Spracheingabe nutzen – so bleibt das tägliche Diktieren sauber von der API-Entwicklung getrennt.
Erste Schritte: So geht es weiter
Bereit, Spracherkennung in deine App einzubauen?
Definiere deine Anforderungen: Echtzeit oder Batch? Welche Sprachen? Priorität auf Genauigkeit oder Geschwindigkeit?
Starte mit kostenlosen Testzugängen: Die meisten APIs bieten Gratis-Guthaben. Teste sie mit deinen echten Audiodateien.
Miss die Performance: Teste Genauigkeit, Latenz und Kosten unter realistischen Bedingungen.
Plane die Skalierung: Bedenke die Kosten und die Performance bei steigendem Datenvolumen.
Für einen No-Code-Workflow teste die kostenlose Testversion von Voicy, um noch heute direkt in deine Tools zu diktieren. Entwickler, die eine Spracheingabe für KI-Coding-Assistenten suchen, können auch die Spracherkennung in Claude Code nutzen und die API-Arbeit separat halten.